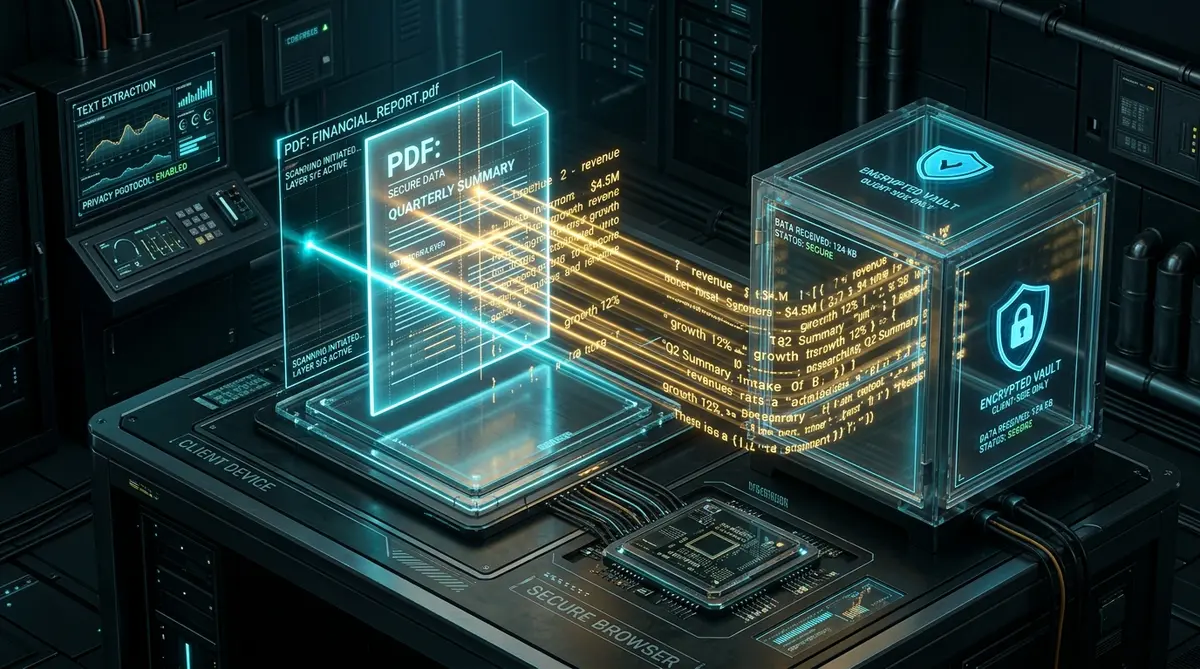
1. Kritische Datenschutzrisiken herkömmlicher Cloud-PDF-Parser
Das Portable Document Format (PDF) ist das unangefochtene weltweite Rückgrat digitaler Geschäftsdokumente. Täglich werden Milliarden von PDF-Dateien zwischen Unternehmen, Anwaltskanzleien, Kliniken und Behörden ausgetauscht. Doch die Arbeit mit PDFs birgt ein wiederkehrendes Ärgernis: Den Textinhalt für nachgelagerte Analysen, Berichte oder die Datenverarbeitung in sauberen, bearbeitbaren Text zu überführen, erweist sich oft als unerwartet mühsam.
Konfrontiert mit gesperrtem Text greifen Mitarbeiter reflexartig auf kostenlose Online-Konverter zurück, die in Suchmaschinen ganz oben stehen. Was bei einem solchen Upload geschieht, ist ein enormes Sicherheitsrisiko. Wenn Sie eine jährliche Finanzprüfung, einen Arbeitsvertrag oder ein Übernahmeangebot auf einen Online-Konverter ziehen, initiiert Ihr Browser eine unverschlüsselte oder unzureichend gesicherte HTTP-POST-Anfrage.
Die gesamte PDF-Binärdatei – mit vertraulichen Bilanzen, Sozialversicherungsnummern, Geschäftsgeheimnissen oder Kundenkonten – gelangt auf fremde Cloud-Server. Dort wird die Datei auf temporären Festplatten abgelegt, durch mandantenfähige Skripte verarbeitet und in Backup-Caches gespeichert. Obwohl kommerzielle Plattformen versichern, Dateien nach einer Stunde zu löschen, zeigen Sicherheitsaudits immer wieder, dass Logdateien, Telemetriedaten und Datenbank-Snapshots noch nach Wochen Reste vertraulicher Dokumente enthalten.
Für Datenschutzbeauftragte, Juristen und medizinisches Personal stellt dieser unkontrollierte Upload eine unmittelbare Verletzung gesetzlicher Vorgaben dar. Ein einziges Dokument mit Patientendaten oder Bankinformationen verstößt bei einer solchen Übertragung gegen die DSGVO, HIPAA oder ISO-27001-Zertifizierungen.
2. PDF-Architektur im Detail: Content Streams, Font-CMaps und Glyphen
Um zu verstehen, warum die lokale Textextraktion im Browser so verlässlich ist, muss man die interne Struktur von PDF-Dateien betrachten. Anders als eine Textdatei oder HTML-Seite ist ein PDF kein fortlaufender Textstrom. Es handelt sich im Grunde um ein PostScript-Grafikprogramm, das Formen und Schriftzeichen an exakten Koordinaten (X, Y) auf einer virtuellen Seite platziert.
In einer ISO-32000-konformen PDF-Datei liegt der Text innerhalb komprimierter Content Streams, gesteuert durch Grafikoperatoren wie BT (Begin Text), Tf (Schriftart festlegen) und Tj (Textzeichen anzeigen).
Wenn unsere clientseitige Parsing-Engine in Ihrem Browser ausgeführt wird, orchestriert sie eine präzise Parsing-Sequenz vollständig im Arbeitsspeicher Ihres PCs:
- Binäre Header- & XREF-Analyse: Der Browser liest die Querverweistabelle (XREF) der Datei direkt aus dem Speicher und ermittelt die exakten Byte-Offsets der Seitenobjekte.
- Dekompression von FlateDecode-Streams: Seiteninhalte werden in Echtzeit mittels zlib und WebAssembly entpackt, wodurch die reinen PostScript-Befehlsfolgen freigelegt werden.
- Auflösung von Font-CMaps (ToUnicode): Schriftzeichen in PDFs sind selten in einfachem ASCII gespeichert; oft werden interne Glyphen-Nummern verwendet. Die Engine nutzt die ToUnicode-Tabelle, um diese Glyphen exakt in standardisierte UTF-8-Zeichen zurückzuübersetzen.
- Koordinatensortierung & Absatzbildung: Einzelne Zeichenfragmente werden anhand ihrer geometrischen Koordinaten sortiert, Wortabstände werden berechnet und Zeilen zu logischen Absätzen zusammengefügt.
- Automatische Speicherbereinigung: Nach der Verarbeitung einer Seite wird deren Grafikspeicher sofort freigegeben, sodass selbst hunderte Seiten starke Dokumente ohne Leistungseinbußen verarbeitet werden.
Da dieser gesamte Prozess innerhalb der lokalen Sandbox Ihres Browsers stattfindet, sendet Ihr Computer während der Extraktion kein einziges Datenpaket ins Netzwerk. Trennen Sie einfach Ihr WLAN – die Textextraktion läuft offline mit voller Geschwindigkeit weiter.
Reinen Text sicher aus jeder PDF-Datei extrahieren
Ziehen Sie ein beliebiges PDF-Dokument hinein, um Formatierungsballast zu entfernen und sauberen Klartext direkt im Arbeitsspeicher Ihres Browsers zu erhalten. Null Server-Uploads, keine Dateigrößenbegrenzung.
3. Schritt-für-Schritt-Anleitung: Text offline extrahieren
Das Extrahieren von durchsuchbarem Text aus digitalen PDFs dauert mit unserer clientseitigen Lösung nur wenige Augenblicke:
Schritt 1: Clientseitigen PDF-Extraktor öffnen
Öffnen Sie den aFolks PDF-zu-Text-Extraktor in einem modernen Browser (Chrome, Firefox, Edge oder Safari). Die Anwendung lädt blitzschnell aus dem Browser-Cache.
Schritt 2: PDF-Datei ablegen oder auswählen
Ziehen Sie Ihre PDF-Datei direkt in das gestrichelte Upload-Feld oder wählen Sie sie von Ihrer lokalen Festplatte aus. Die Datei wird sofort in den Arbeitsspeicher geladen.
Schritt 3: Lokale Stream-Analyse in Echtzeit
Die Engine verarbeitet die Seitenstruktur in Echtzeit, löst Schriftkodierungen auf und rekonstruiert Zeilen. Eine Live-Statistik informiert über Seitenanzahl, Wörter und Zeichen.
Schritt 4: Text kopieren oder als TXT herunterladen
Klicken Sie auf Text kopieren, um das Ergebnis in die Zwischenablage zu übernehmen, oder auf TXT herunterladen, um eine saubere Textdatei auf Ihrem PC zu speichern.
4. Technischer Vergleich: Lokales PDF.js vs. Cloud-Dienste
Die nachstehende Gegenüberstellung verdeutlicht die grundlegenden Unterschiede zwischen browserbasiertem PDF.js-Parsing und traditionellen Cloud-Diensten:
| Merkmal / Architektur | aFolks Lokaler Browser-Extraktor | Kommerzielle Cloud-APIs (Adobe / AWS) | Kostenlose Online-Webkonverter |
|---|---|---|---|
| Verarbeitungsumgebung | 100% Client-RAM (Lokales Gerät) | Entfernte Cloud-Server | Ungeprüfte Drittanbieter-Server |
| Netzwerkübertragung | Null Bytes (Vollständig offline) | Gesamte Datei wird hochgeladen | Gesamte Datei wird hochgeladen |
| Geschwindigkeit | Sofort (Keine Upload-Wartezeit) | Netzwerkabhängig (2–15 Sekunden) | Langsam (Warteschlangen & Werbung) |
| Nutzungslimits | Unbegrenzte Seitenanzahl | Kosten pro Seite / API-Abrechnung | Begrenzt auf 2–5 Dateien täglich |
| Datenschutzrisiko | Null (Keine Serverspeicherung) | Erfordert AV-Verträge (DPA / BAA) | Extrem hohes Sicherheitsrisiko |
| Dateigrößenbeschränkung | Nur durch PC-RAM begrenzt | Durch HTTP-Limits beschränkt | Strikte Limits (meist 15–50 MB) |
5. Umgang mit komplexen Layouts: Spaltensatz, Tabellen und Leerraum
Jeder, der schon einmal Text aus mehrspaltigen PDFs kopiert hat, kennt das Phänomen: Zeilen verschiedener Spalten vermischen sich zu unlesbarem Buchstabensalat. Unsere Lösung löst dieses Problem durch räumliche Sortieralgorithmen:
1. Vertikale Y-Sortierung
Schriftzeichen auf derselben Grundlinie werden gruppiert, sodass benachbarte Textzeilen sauber getrennt bleiben.
2. Horizontale X-Sortierung
Innerhalb einer Zeile werden Textfragmente von links nach rechts geordnet und echte Wortzwischenräume exakt rekonstruiert.
3. Spaltenerkennung
Breite Leerräume zwischen Spalten werden erkannt, sodass Spalte eins von oben bis unten gelesen wird, bevor Spalte zwei folgt.
4. Ligaturen-Auflösung
Typografische Ligaturen (wie 'fi' oder 'fl') werden automatisch in durchsuchbare Einzelbuchstaben aufgeteilt.
6. Praktische Einsatzbereiche: Bilanzen, Lebensläufe und Verträge
Die vertrauliche Textextraktion im Browser steigert die Produktivität in zahlreichen datensensiblen Branchen:
- Finanzberichte & Bilanzen: Analysten müssen Daten aus Geschäftsberichten schnell in Excel oder Python überführen. Das manuelle Abtippen von Zahlenkolonnen entfällt vollständig. Wenn Sie mehrere Berichte vorab bündeln möchten, nutzen Sie unsere Anleitung zum privaten Zusammenführen von PDFs.
- Bewerbermanagement & ATS-Resumes: HR-Abteilungen prüfen hunderte Lebensläufe. Das Konvertieren in Klartext ermöglicht schnelle Stichwortprüfungen, ohne Kandidatendaten an externe Portale zu übermitteln.
- Juristische Schriftsätze & Verträge: Anwälte und Notare analysieren umfangreiche Vertragsakten. Die lokale Umwandlung in Text erlaubt schnelle Volltextsuchen unter Wahrung des Berufsgeheimnisses.
- Wissenschaftliche Arbeiten: Forscher extrahieren Literaturverzeichnisse und Zitate aus Fachpublikationen ohne fehlerhafte Silbentrennungen oder störende Kopfzeilen.
7. Unternehmens-Compliance: DSGVO Artikel 32 und Datenhoheit
Unternehmen stehen unter strenger Aufsicht bezüglich des Schutzes personenbezogener Daten. Nach Artikel 32 der DSGVO müssen angemessene technische Schutzmaßnahmen getroffen werden.
Lädt ein Mitarbeiter Dokumente auf einen unregulierten Cloud-Dienst hoch, liegt eine unzulässige Auftragsverarbeitung vor, die ohne AV-Vertrag bußgeldbewehrt ist. Clientseitige WebAssembly- und PDF.js-Werkzeuge schließen dieses Risiko dauerhaft aus.
Da die Daten das Gerät niemals verlassen, entstehen keine externen Datenspuren und Sicherheitsverantwortliche können die Tools ohne Vorbehalte für den Unternehmensalltag autorisieren.