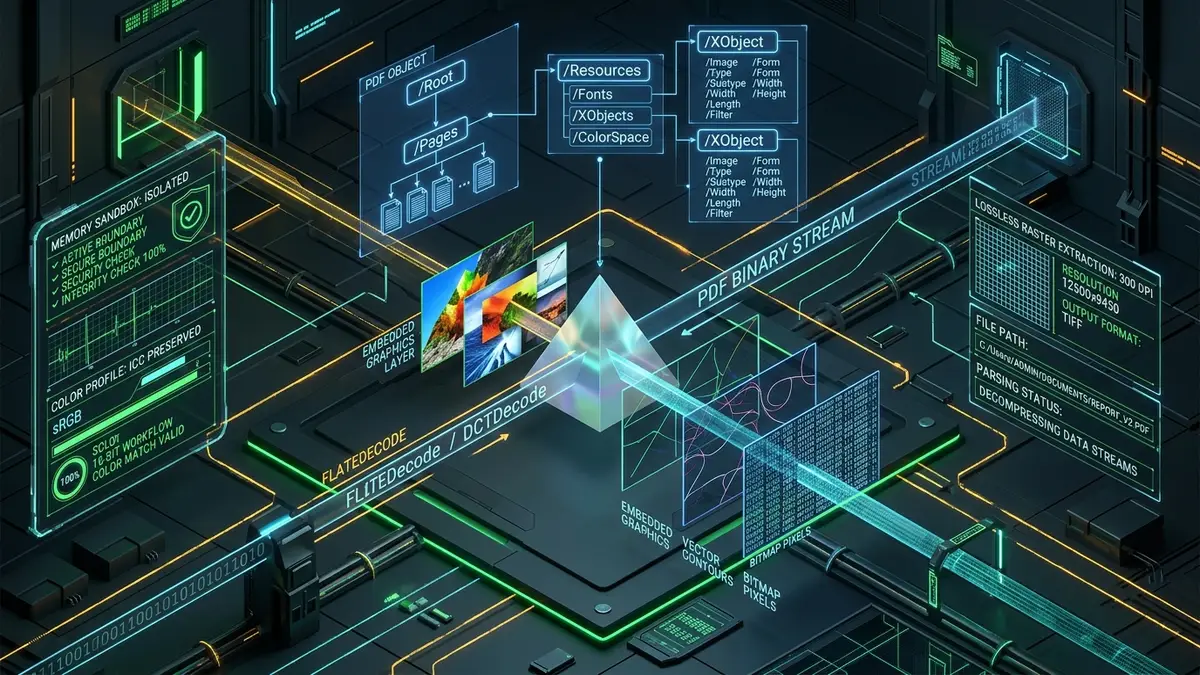
L'anatomie interne du format PDF : comment les images y sont structurées
La majorité des utilisateurs perçoivent un document PDF (Portable Document Format) comme une feuille de papier virtuelle figée dans le marbre. Cependant, sous cette couche de rendu graphique, la norme ISO 32000-1 définit une base de données d'objets hiérarchique complexe nommée Carousel Object System (COS). Un document PDF ne constitue pas une simple planche de pixels assemblés, mais un ensemble hautement structuré de dictionnaires, de références croisées, de flux d'instructions et de données binaires brutes.
Au sommet de cette arborescence se situe le dictionnaire de catalogue (noté /Root), qui oriente les moteurs d'interprétation vers les métadonnées et la hiérarchie des pages /Pages. Lorsque le moteur parcourt chaque page, celle-ci fait appel à un dictionnaire de ressources dédié /Resources. Les éléments graphiques intégrés ne sont pas enregistrés sous forme de pièces jointes volantes, mais sont encapsulés dans un sous-dictionnaire spécifique désigné par /XObject (External Objects) muni de l'attribut /Subtype /Image.
Chaque XObject d'image comporte des attributs techniques essentiels qui déterminent l'interprétation exacte des pixels bruts :
- /Width et /Height : Les dimensions matricielles réelles de l'image source en pixels, totalement indépendantes de la taille d'affichage de la boîte englobante sur la page imprimée.
- /ColorSpace : Indique si les pixels sont encodés en
/DeviceRGB,/DeviceCMYK,/DeviceGrayou à travers un profil colorimétrique ICC étalonné. - /BitsPerComponent : La profondeur d'échantillonnage par canal (généralement 8 bits pour les photographies, 1 bit pour les numérisations de texte ou 16 bits pour l'imagerie médicale).
- /Filter : L'algorithme de compression appliqué au flux binaire. Parmi les filtres les plus répandus figurent
/DCTDecodepour la compression avec perte standard JPEG,/FlateDecodepour la compression zlib/deflate sans perte,/JPXDecodepour les ondelettes JPEG 2000 et/CCITTFaxDecodepour les documents monochromes numérisés. - /SMask (Soft Mask) : Un flux auxiliaire en niveaux de gris de 8 bits qui fournit la couche de transparence alpha indispensable pour les visuels détourés.
Lorsqu'un outil d'extraction dédié entre en action, il navigue directement vers ces descripteurs /XObject, fait abstraction des lignes de texte du document et récupère le flux binaire compressé original directement dans les octets du fichier. Comprendre ce fonctionnement permet de mesurer pourquoi les méthodes superficielles échouent et pourquoi l'extraction directe de flux constitue l'unique standard professionnel.
Le piège des captures d'écran : pourquoi rogner dégrade la qualité
Lorsqu'un professionnel a besoin d'un schéma, d'un logo ou d'une photographie intégrée dans un rapport PDF, son premier réflexe consiste souvent à zoomer sur l'écran, ouvrir un utilitaire de rognage et effectuer une capture d'écran. Bien que cette méthode semble immédiate, elle inflige aux images des dégradations visuelles sévères et irréversibles.
La contrainte fondamentale découle de la résolution de restitution des moniteurs. Les écrans informatiques standards affichent les images avec une densité de 72 à 96 DPI (points par pouce), tandis que les dalles 4K ou Retina haut de gamme atteignent 144 à 220 DPI. En revanche, les maquettes professionnelles, les catalogues de produits et les publications techniques intègrent des images sources étalonnées entre 300 et 600 DPI afin de garantir une impression papier irréprochable.
En effectuant une capture d'écran, vous n'obtenez donc jamais l'image réelle conservée dans le PDF, mais uniquement l'interpolation visuelle dégradée que votre système d'exploitation applique pour la projeter sur la grille de votre moniteur. Le tableau comparatif ci-dessous met en lumière les écarts manifestes entre une capture d'écran manuelle et une extraction binaire directe :
| Critère technique | Capture d'écran système | Extraction directe du flux /XObject |
|---|---|---|
| Résolution réelle (DPI) | 72 - 144 DPI (Limitée à l'écran) | 300 - 600+ DPI (Fidélité source maître) |
| Dimensions en pixels | Restreintes à la taille de la fenêtre | Dimensions d'origine (ex. 4000 x 3000 px) |
| Fidélité des profils couleur | Tronquée dans l'espace sRGB restreint | Conserve les profils ICC d'origine (AdobeRGB, CMJN) |
| Gestion de la transparence | Aplatissement sur fond blanc opaque | Canal de transparence alpha 8 bits /SMask préservé |
| Netteté des contours | Flou d'anticrénelage et bavures | Aucun artefact d'interpolation ; pixels exacts |
De plus, réaliser des captures manuelles sur un dossier de plusieurs dizaines de pages fait perdre un temps précieux à vos collaborateurs. Grâce à l'extraction de flux native, vous récupérez l'ensemble des éléments maîtres en quelques secondes, sans aucun résidu de curseur, distorsion de perspective ou flou de redimensionnement.
Les risques des convertisseurs cloud : fuites de données et responsabilités
Pour éviter les contraintes des captures d'écran, un grand nombre d'entreprises et d'utilisateurs se tournent vers les convertisseurs PDF gratuits en ligne. Cependant, ce qui ressemble à un service pratique dissimule souvent de sérieux risques en matière de confidentialité et de conformité réglementaire.
Les convertisseurs web traditionnels reposent sur une architecture cloud centralisée : dès que vous glissez un PDF dans l'interface, la totalité de votre fichier est transmise via Internet vers des serveurs distants dont la sécurité est incertaine. Lors des audits de sécurité menés par les équipes de afolksdigital.com, nous avons constaté que de nombreuses plateformes conservent des copies temporaires non chiffrées sur leurs disques et appliquent des politiques de rétention opaques.
Lorsque vos documents contiennent des bilans financiers, des plans de fabrication, des données de santé, des contrats de vente ou des informations personnelles identifiables (PII), leur transfert sur ces plateformes enfreint directement des réglementations majeures :
- Règlement Général sur la Protection des Données (RGPD) : L'article 28 interdit formellement de transmettre des données à caractère personnel à des sous-traitants sans accord de traitement de données (DPA) et sans garanties de sécurité vérifiables.
- Accords de confidentialité (NDA) et secret professionnel : Le téléversement de secrets industriels ou de photographies de produits confidentiels sur des serveurs tiers engage directement la responsabilité juridique de l'entreprise.
- Sécurité financière et bancaire : Les institutions financières ne peuvent pas déléguer le traitement de documents sensibles à des services sans traçabilité ni hébergement souverain.
Pour éliminer ces risques, les organisations doivent impérativement s'orienter vers des utilitaires web exécutés exclusivement côté client, qui traitent les flux documentaires dans le bac à sable du navigateur local.
Vous devez extraire des photographies, des graphiques ou des schémas haute résolution depuis des documents confidentiels ? Notre extracteur PDF traite les flux directement sur votre appareil. Vos données ne quittent jamais votre ordinateur, garantissant un secret absolu et une netteté totale.
Comparatif architectural : Navigateur local vs SaaS Cloud vs Terminal CLI
Le choix d'une méthode d'extraction implique de mettre en balance le niveau de sécurité, la simplicité d'utilisation et les performances de traitement. Ce tableau présente les caractéristiques comparées des principales approches :
| Méthode d'extraction | Trafic réseau sortant | Installation requise | Maintien de la qualité | Niveau de confidentialité |
|---|---|---|---|---|
| Navigateur local (WebAssembly/PDF.js) | Nul (0 octet transféré) | Aucune (Exécution directe dans le navigateur) | 100% Extraction maître bit par bit | Sécurité maximale (Mémoire sandbox) |
| Convertisseurs Web Cloud (SaaS externe) | Téléversement complet du document | Aucune (Nécessite une connexion web) | Aléatoire (Recompression souvent destructrice) | Vulnérable (Stockage distant non maîtrisé) |
| Ligne de commande Poppler (pdfimages -png) | Nul (Exécution locale en console) | Élevée (Gestionnaire de paquets requis) | 100% Extraction brute bit à bit | Sécurité maximale (Compatible hors-ligne) |
| Éditeurs PDF lourds (ex. Adobe Acrobat Pro) | Faible à moyen (Synchronisation cloud fréquente) | Lourde (Abonnement coûteux et installation volumineuse) | Élevée (Flux originaux préservés) | Moyen (Télémétrie et sauvegardes automatiques) |
Si les outils en console comme pdfimages conviennent parfaitement aux administrateurs systèmes, les applications web modernes côté client offrent la même garantie de confidentialité et la même fidélité visuelle absolue, tout en demeurant immédiatement accessibles à tous les corps de métier de l'entreprise.
Guide pas à pas : Extraire des images en haute fidélité en 4 étapes
Pour extraire vos visuels sans aucune dégradation et en protégeant l'intégrité de vos fichiers, appliquez la méthodologie suivante :
Rendez-vous sur l'extracteur PDF vers image depuis votre navigateur web habituel. Vous pouvez même déconnecter votre connexion Internet ou surveiller l'onglet Réseau des outils de développement : l'outil s'exécute de façon autonome et totalement hors ligne.
Déposez simplement votre fichier dans l'espace dédié. Le navigateur charge les données via l'API HTML5 File et FileReader.readAsArrayBuffer() dans la mémoire RAM locale. Si le fichier est protégé par un mot de passe utilisateur, une invite locale vous permettra de déchiffrer le document via AES sans envoyer le mot de passe sur le réseau.
Choisissez l'option qui correspond à votre projet. Pour récupérer les photographies et illustrations intégrées dans leur résolution d'origine, activez Extraire les images intégrées. Si votre document contient des mises en page complexes, des typographies élaborées ou des infographies vectorielles, choisissez Rendre les pages en 300 DPI pour obtenir des planches intégrales à très haute définition.
L'interface génère instantanément une prévisualisation de chaque ressource avec ses dimensions réelles en pixels et son profil colorimétrique. Vous pouvez enregistrer les images une par une ou cliquer sur Tout télécharger en ZIP pour récupérer l'intégralité du lot sur votre disque dur sans aucune compression destructrice.
Cas techniques complexes : Mots de passe, espaces CMJN & masques alpha
Dans l'environnement de production graphique, les documents PDF comportent fréquemment des subtilités techniques qui font échouer les scripts basiques ou dénaturent le rendu final. Savoir gérer ces spécificités est indispensable pour obtenir des résultats professionnels :
1. Inversion des teintes et conversion de l'espace colorimétrique CMJN
Les catalogues et plaquettes conçus pour l'impression industrielle sont élaborés dans l'espace colorimétrique CMJN (Cyan, Magenta, Jaune, Noir). Si un outil d'extraction non calibré lit ce flux comme un flux RVB, l'image résultante présentera des couleurs inversées ou anormalement fluorescentes. Notre moteur web inspecte automatiquement le dictionnaire /ColorSpace et applique une matrice de conversion ICC en mémoire vive pour traduire le CMJN en sRGB standard sans dérive chromatique.
2. Détourages transparents et masques logiciels (/SMask)
À l'inverse des fichiers PNG autonomes qui stockent la transparence directement avec les canaux RVB, les normes PDF séparent souvent la chrominance et la découpe. L'image en couleurs est conservée dans un flux RVB, tandis que la transparence réside dans un flux distinct en niveaux de gris (/SMask). Les outils simplistes ne récupèrent que l'image colorée sur fond noir ou blanc. Notre outil réunit ces deux flux grâce à un OffscreenCanvas pour reconstituer un véritable fichier PNG transparent.
3. Visuels intégrés en ligne et pictogrammes compacts
Certains éléments légers (puces, icônes décoratives) sont insérés directement au milieu des flux d'instructions textuelles à l'aide des balises BI (Begin Image), ID (Image Data) et EI (End Image), au lieu d'être déclarés comme /XObject. L'identification de ces micro-éléments requiert une analyse lexicale avancée des jetons du document, exécutée de façon fluide par nos parseurs WebAssembly.
Conformité en entreprise, audits de sécurité & stratégie écosystémique
Dans les grandes entreprises, les équipes de sécurité informatique déploient des systèmes de prévention contre les fuites de données (DLP). Lorsque des employés transmettent des fichiers d'entreprise sur des plateformes de conversion externes, ces systèmes déclenchent immédiatement des alertes de sécurité. L'adoption d'outils s'exécutant à 100 % dans le navigateur élimine tout trafic sortant et concilie sécurité opérationnelle et confort d'utilisation.
Les équipes d'audit et de conseil chez afolksdigital.com accompagnent les organisations dans la mise en œuvre de solutions d'ingénierie web sécurisées et d'architectures documentaires locales. En réduisant les dépendances aux abonnements cloud récurrents, les structures diminuent leurs coûts d'infrastructure tout en renforçant leur conformité réglementaire.
Pour les analystes financiers et les gestionnaires de fonds évaluant des indicateurs de valorisation, des bilans comptables ou des flux de trésorerie extraits de rapports annuels, nos calculateurs spécialisés disponibles sur academy.afolksdigital.com garantissent des modélisations mathématiques précises et confidentielles.
Pour former vos équipes d'ingénierie et de conformité aux technologies WebAssembly, à l'analyse structurée de documents et aux architectures zero-trust, découvrez nos programmes de formation technique approfondis sur learn.afolksdigital.com.