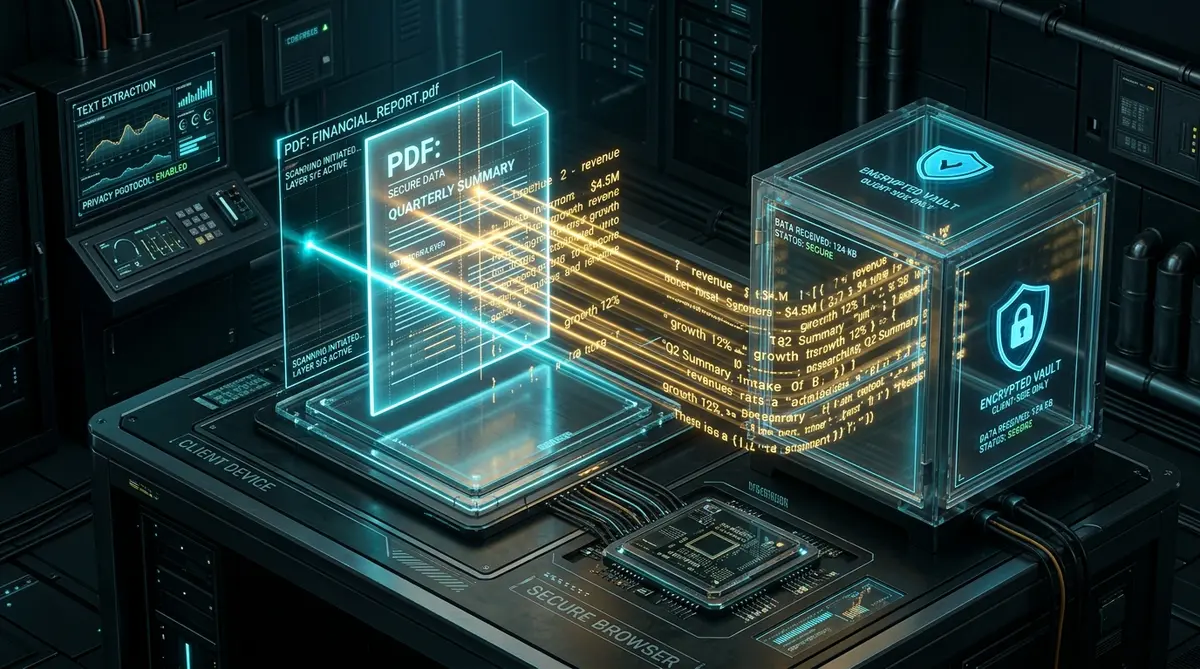
1. Критические риски конфиденциальности стандартных облачных конвертеров
Формат Portable Document Format (PDF) стал безальтернативным глобальным фундаментом для обмена деловой корреспонденцией, финансовыми отчетами и юридическими актами. Ежедневно миллиарды файлов PDF пересылаются между корпорациями, адвокатскими коллегиями, медицинскими учреждениями и государственными ведомствами. Тем не менее извлечение исходного редактируемого текста для последующего анализа или составления сводных таблиц по-прежнему вызывает сложности.
Столкнувшись с необходимостью скопировать заблокированный или сложно сверстанный текст, сотрудники зачастую обращаются к первым попавшимся бесплатным онлайн-конвертерам в поисковой выдаче. То, что кажется простым и быстрым действием, таит в себе колоссальную угрозу информационной безопасности. В момент отправки аудиторского отчета, трудового договора или финансового баланса на сторонний веб-сервис браузер выполняет стандартный HTTP POST-запрос на неизвестный удаленный сервер.
Исходный бинарный файл со всеми персональными данными, номерами счетов, налоговыми идентификаторами и коммерческой тайной сохраняется на чужих жестких дисках. Там он обрабатывается скриптами общего пользования и попадает во временные резервные копии. Даже если операторы сервиса декларируют автоматическое удаление файлов через час, практические аудиты показывают, что логирование серверов, дампы памяти и служебная телеметрия могут сохранять остаточные фрагменты документов неделями.
Для специалистов по комплаенсу, корпоративных юристов и служб безопасности подобная отправка документов представляет прямое нарушение законодательства о защите персональных данных (включая 152-ФЗ и GDPR). Утечка врачебной или коммерческой тайны грозит огромными штрафами и невосполнимыми репутационными потерями.
2. Внутренняя архитектура PDF: Потоки данных, шрифтовые таблицы ToUnicode и глифы
Чтобы оценить надежность локального извлечения текста в браузере, необходимо понимать внутреннее устройство PDF-формата. В отличие от файлов Word или страниц HTML, документ PDF не хранит линейный поток предложений. Фактически это программа графических команд PostScript, которая указывает виртуальному холсту точные декартовы координаты (X и Y) для отрисовки каждого отдельного знака.
В рамках международного стандарта ISO 32000 текст упакован в сжатые потоки контента (Content Streams), управляемые командами BT (начало текстового блока), Tf (выбор гарнитуры и кегля) и Tj (отображение текстовой строки).
Когда наш клиентский движок запускается в вашем браузере, он выполняет строгую последовательность операций непосредственно в оперативной памяти (RAM) компьютера:
- Анализ бинарных заголовков и таблицы XREF: Браузер мгновенно считывает таблицу перекрестных ссылок из памяти, определяя точные байтовые смещения объектов каждой страницы без долгих поисков.
- Распаковка потоков FlateDecode: Сжатые блоки контента распаковываются в реальном времени с помощью библиотек zlib и WebAssembly, открывая чистые цепочки графических инструкций.
- Преобразование глифов через таблицы ToUnicode: В PDF-документах символы часто зашифрованы внутренними числовыми индексами (глифами). Движок сопоставляет их с таблицей ToUnicode, конвертируя каждый глиф в корректный символ стандарта UTF-8.
- Пространственная сортировка и склеивание строк: Извлеченные текстовые фрагменты сортируются по их геометрическим координатам, рассчитываются межсловные интервалы и формируются осмысленные абзацы.
- Автоматическая очистка памяти: По завершении обработки каждой страницы занятая память немедленно освобождается сборщиком мусора, что позволяет обрабатывать документы объемом в сотни страниц без зависания браузера.
Поскольку весь этот процесс изолирован внутри песочницы (sandbox) вашего веб-обозревателя, компьютер не отправляет в сеть ни одного пакета данных. Вы можете полностью отключить интернет — извлечение текста продолжит работать с предельной скоростью в автономном режиме.
Извлеките чистый текст из любого PDF безопасно
Перетащите PDF-файл, чтобы избавиться от лишнего форматирования и получить чистый текст прямо в оперативной памяти браузера. Без серверов и ограничений по объему.
3. Пошаговое руководство: Извлечение текста в офлайн-режиме
Процесс получения редактируемого текста из цифрового документа с помощью клиентского экстрактора занимает считаные секунды:
Шаг 1: Откройте инструмент в браузере
Перейдите на страницу Экстрактора PDF в текст от aFolks в любом современном веб-браузере (Google Chrome, Яндекс.Браузер, Mozilla Firefox или Safari).
Шаг 2: Добавьте ваш PDF-документ
Перетащите файл в зону загрузки либо нажмите на нее для выбора файла из локального хранилища вашего компьютера. Документ мгновенно подгружается в память.
Шаг 3: Локальный парсинг в реальном времени
Движок последовательно считывает страницы, декодирует таблицы шрифтов и собирает текст. На панели отображается точное количество обработанных страниц, слов и знаков.
Шаг 4: Скопируйте текст или скачайте TXT-файл
Нажмите Скопировать текст для отправки результата в буфер обмена либо выберите Скачать файл TXT для сохранения готового текста на диск.
4. Техническое сравнение: Локальный движок браузера vs Облачные сервисы
В таблице наглядно сопоставлены архитектурные особенности локального решения aFolks и классических облачных инструментов:
| Критерий / Архитектура | Локальный экстрактор aFolks (Браузер) | Коммерческие Cloud API (Adobe / AWS) | Бесплатные веб-конвертеры |
|---|---|---|---|
| Среда вычислений | 100% RAM клиента (Ваш ПК) | Удаленные облачные кластеры | Сторонние несертифицированные серверы |
| Сетевой трафик | 0 байт (Полностью автономно) | Полная передача файла по сети | Полная передача файла по сети |
| Скорость работы | Мгновенно (Без задержек загрузки) | Зависит от канала связи (2–15 сек) | Низкая (Очереди обработки и реклама) |
| Лимиты использования | Без ограничений и подписок | Оплата за каждую страницу / квота API | Ограничение до 2–3 файлов в сутки |
| Риск утечки данных | Исключен (Нет сохранения файлов) | Требует соглашений DPA / BAA | Критический уровень риска |
| Ограничение размера файла | Ограничено только памятью вашего ПК | Лимиты на размер HTTP-пакетов (100 МБ) | Жесткие лимиты (обычно 15–50 МБ) |
5. Обработка сложной верстки: Колонки, таблицы и отступы
Любой пользователь, копировавший текст из многоколоночных PDF-статей, знает главную проблему: строки из соседних столбцов склеиваются в хаотичную кашу. Наш алгоритм предотвращает эту ошибку благодаря двумерной пространственной группировке:
1. Вертикальное выравнивание по оси Y
Символы на одной базовой линии объединяются в единые строки, что исключает разрыв предложений на полуслове.
2. Горизонтальная упорядоченность по оси X
Внутри каждой строки знаки выстраиваются слева направо с точным расчетом естественных пробелов между словами.
3. Умное распознавание колонок
Широкие разрывы между текстовыми массивами расцениваются как границы колонок: сначала целиком читается левая колонка, а затем правая.
4. Разделение типографических лигатур
Слитные начертания букв (например, 'fi', 'fl') разделяются на стандартные самостоятельные символы для корректного поиска.
6. Практическое применение: Балансы, резюме и договоры
Возможность конфиденциально конвертировать PDF в текст ускоряет рутинные операции специалистов ключевых отраслей:
- Финансовая аналитика и бухгалтерия: Аналитики быстро выгружают данные из квартальных балансов и отчетов для загрузки в Excel или базы данных без ручного перепечатывания. Если вам требуется объединить несколько отчетов перед анализом, ознакомьтесь с нашим руководством о том, как объединять PDF-файлы конфиденциально в браузере.
- HR-департаменты и системы рекрутинга (ATS): Специалисты по кадрам получают сотни резюме кандидатов. Конвертация в простой текст упрощает автоматизированный скрининг по ключевым навыкам без риска передачи персональных данных соискателей сторонним сервисам.
- Юридические службы и нотариат: Адвокаты и корпоративные юристы работают с многостраничными договорами. Локальное извлечение позволяет быстро находить скрытые условия при полном соблюдении адвокатской тайны.
- Научная работа и образование: Исследователи могут быстро извлекать списки литературы, цитаты и выдержки из академических монографий без лишних колонтитулов и номеров страниц.
7. Корпоративный комплаенс: Защита данных и цифровой суверенитет
Современное законодательство возлагает на бизнес прямую обязанность защищать персональные данные сотрудников и клиентов. Согласно ст. 19 Федерального закона № 152-ФЗ и ст. 32 регламента GDPR, оператор обязан принимать необходимые организационные и технические меры для исключения несанкционированного доступа к информации.
Загрузка документов на общедоступные конвертеры юридически приравнивается к передаче информации неавторизованным третьим лицам. Использование клиентских технологий на базе WebAssembly и PDF.js полностью устраняет данный комплаенс-риск.
Информация остается под вашим абсолютным контролем, что дает службам безопасности основание беспрепятственно утверждать данный веб-инструмент для ежедневного корпоративного использования.