Внутреннее устройство PDF: как изображения хранятся внутри документов
Подавляющее большинство пользователей воспринимает формат PDF (Portable Document Format) как плоский виртуальный аналог распечатанного листа бумаги. Однако под этим поверхностным слоем визуализации спецификация ISO 32000-1 описывает сложную иерархическую базу данных объектов, называемую Carousel Object System (COS). Файл PDF — это вовсе не единое полотно пикселей, а упорядоченная сеть взаимных ссылок, словарей, потоков команд и бинарных массивов данных.
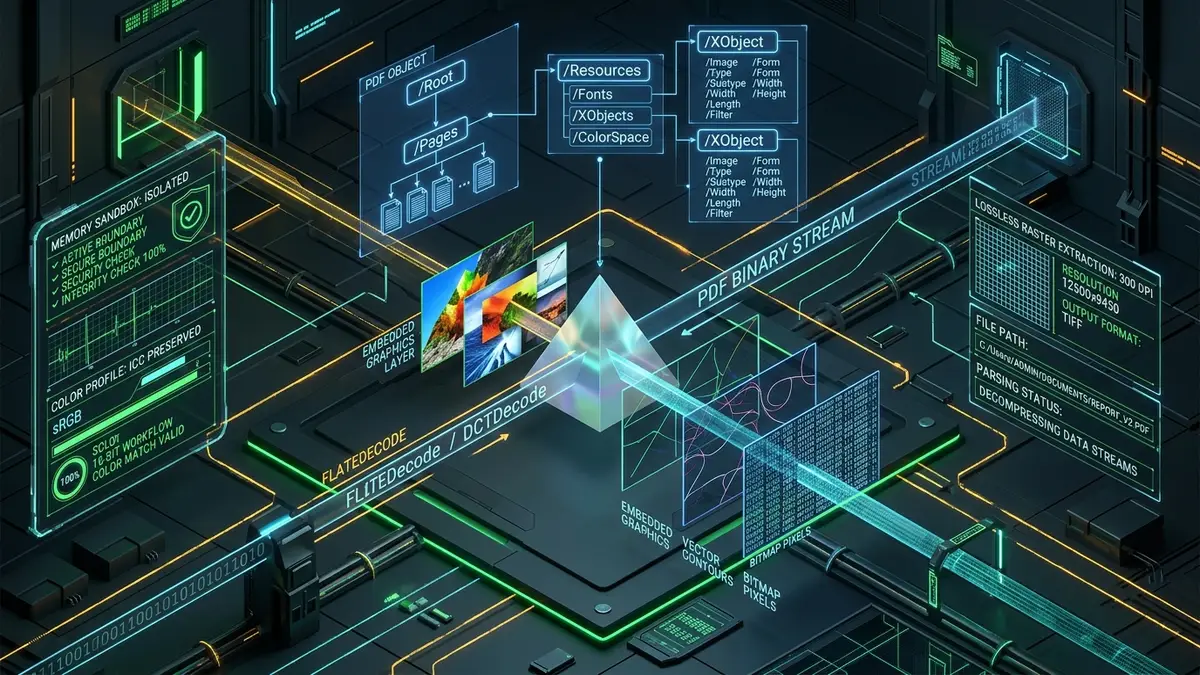
На вершине объектного дерева находится корневой словарь каталога (обозначаемый как /Root), который направляет обработчики к метаданным и иерархическому дереву страниц /Pages. По мере того как программа считывает отдельные страницы, каждая из них обращается к собственному словарю ресурсов /Resources. Встроенные изображения не хранятся в виде обычных файловых вложений, а объявляются внутри специализированного словаря /XObject (External Objects) с обязательным указанием типа /Subtype /Image.
Каждый объект изображения XObject содержит фундаментальные технические атрибуты, определяющие точную интерпретацию сырых пикселей:
- /Width и /Height: Собственные геометрические размеры мастер-растра в целых пикселях, совершенно независимые от экранного масштаба ограничивающего блока на странице.
- /ColorSpace: Определяет модель интерпретации цветов:
/DeviceRGB,/DeviceCMYK,/DeviceGrayили калиброванный цветовой профиль стандарта ICC. - /BitsPerComponent: Глубина квантования на каждый цветовой канал (как правило, 8 бит для фотографий, 1 бит для отсканированных чертежей или 16 бит для медицинских томограмм).
- /Filter: Алгоритмический фильтр сжатия потока данных. Среди наиболее распространенных:
/DCTDecodeдля сжатия JPEG с потерями,/FlateDecodeдля упаковки zlib/deflate без потерь,/JPXDecodeдля вейвлет-алгоритма JPEG 2000 и/CCITTFaxDecodeдля монохромных документов. - /SMask (Soft Mask): Дополнительный 8-битный полутоновый поток, обеспечивающий альфа-канал прозрачности для вырезанных объектов и силуэтов.
Специализированный инструмент извлечения обращается напрямую к этим дескрипторам /XObject, минует все инструкции текстового оформления и выгружает исходный сжатый бинарный поток байтов из структуры документа. Понимание этой архитектуры четко объясняет, почему кустарные способы извлечения терпят неудачу и почему прямой парсинг потоков остается единственным профессиональным стандартом для работы с медиаданными.
При этом важно учитывать, что один документ PDF может содержать десятки различных потоков XObject, каждый из которых скомпилирован с уникальными параметрами компрессии. Например, схемы и логотипы часто сжимаются с помощью алгоритма FlateDecode для сохранения идеальной четкости прямых линий, тогда как фоновые фотоиллюстрации используют фильтр DCTDecode. Прямое побитовое извлечение сохраняет каждый из этих форматов в его первозданной чистоте без взаимной перекодировки.
Ловушка экранных скриншотов: почему обрезка экрана уничтожает четкость
Когда сотрудникам требуется скопировать диаграмму, графику или фотографию из служебного отчета PDF, первым побуждением почти всегда становится приближение документа на экране и создание снимка с помощью системной утилиты ножниц. Несмотря на кажущуюся скорость, такой подход наносит графике непоправимый ущерб.
Фундаментальным ограничением выступает физическая плотность пикселей компьютерных дисплеев. Стандартные офисные мониторы отображают картинку с плотностью всего 72–96 DPI (точек на дюйм), тогда как экраны 4K или Retina достигают 144–220 DPI. В то же время в полиграфических макетах, технических спецификациях и годовых отчетах исходные иллюстрации закладываются с разрешением 300–600 DPI для безупречной четкости при печати.
Делая скриншот, вы фиксируете не оригинальный графический объект из PDF, а лишь его урезанную проекцию, интерполированную операционной системой под размер экранной сетки. Приведенная ниже сравнительная таблица наглядно иллюстрирует разрыв в характеристиках между скриншотом и прямым бинарным извлечением:
| Технический параметр | Скриншот экрана монитора | Прямое извлечение потока (/XObject) |
|---|---|---|
| Эффективное разрешение (DPI) | 72 - 144 DPI (Ограничено монитором) | 300 - 600+ DPI (Оригинальное мастер-качество) |
| Размер в пикселях | Ограничен рамкой окна программы | Исходные габариты мастера (напр. 4000 x 3000 px) |
| Точность цветовых профилей | Урезается до стандартного охвата sRGB | Сохраняет встроенные профили (AdobeRGB, CMYK) |
| Обработка прозрачности | Склеивается с белым фоном страницы | Сохраняет чистый 8-битный альфа-канал /SMask |
| Четкость мелких контуров | Размытие из-за субпиксельного сглаживания | Абсолютная попиксельная резкость без артефактов |
Кроме того, ручное кадрирование иллюстраций из каталогов на десятки страниц отнимает колоссальное количество рабочего времени. Потоковое извлечение позволяет сохранить всю графику за пару секунд без следов курсора, перекосов геометрии и искажений масштаба.
Обратная сторона облачных конвертеров: утечки данных и юридические риски
Пытаясь избежать трудоемких скриншотов, пользователи часто обращаются к бесплатным онлайн-конвертерам PDF в сети. Однако за внешней простотой таких платформ нередко скрываются существенные риски для информационной безопасности бизнеса.
Классические веб-конвертеры построены по централизованной модели: как только файл перетаскивается в браузер, он целиком пересылается через интернет на сторонний веб-сервер. Анализ безопасности, проведенный инженерами afolksdigital.com, показал, что многие онлайн-сервисы временно кэшируют документы в открытом виде на своих накопителях и имеют непрозрачные политики уничтожения файлов.
Если PDF содержит бухгалтерские балансы, договоры с клиентами, медицинские карты или сведения, составляющие коммерческую тайну, передача файла сторонним сервисам нарушает базовые регламенты:
- Законодательство о персональных данных (ФЗ-152, GDPR): Передача персональных сведений сторонним организациям без подписанного соглашения об обработке данных категорически запрещена.
- Соглашения о неразглашении (NDA): Отправка чертежей, маркетинговых макетов или финансовых планов на публичные серверы признается грубым нарушением режима конфиденциальности.
- Отраслевые нормативы безопасности: Финансовые институты и предприятия государственного сектора обязаны исключать обработку служебной документации во внешней неаттестованной среде.
Чтобы гарантированно нейтрализовать данные угрозы, организациям необходимо использовать клиентские веб-инструменты, выполняющие разбор файлов локально в оперативной памяти браузера.
Нужно быстро выгрузить фотографии, схемы или графику высокого разрешения из конфиденциального PDF-документа? Наш браузерный экстрактор обрабатывает файл прямо на вашем устройстве. Файлы никогда не покидают память вашего ПК, гарантируя абсолютную тайну данных и безупречную четкость.
Сравнение архитектур: Локальный браузер vs Облачный SaaS vs Консоль CLI
Выбор оптимального способа извлечения графики требует сопоставления уровней защиты, простоты развертывания и скорости обработки. В таблице сопоставлены ключевые характеристики существующих подходов:
| Способ извлечения | Исходящий сетевой трафик | Требования к установке | Сохранение исходного качества | Уровень приватности |
|---|---|---|---|---|
| Локальный браузер (WebAssembly/PDF.js) | Отсутствует (0 байт передано) | Не требуется (Работает в браузере) | 100% Побитовое мастер-извлечение | Максимальный (Изолированная память) |
| Облачные конвертеры (Сторонние SaaS) | Полная загрузка файла на сервер | Не требуется (Нужен интернет) | Нестабильное (Частое сжатие с потерями) | Высокий риск (Хранение на чужих серверах) |
| Консольные утилиты (pdfimages -png) | Отсутствует (Локальный терминал) | Высокие (Нужны Homebrew, Linux или MinGW) | 100% Чистое побитовое извлечение | Максимальный (Работает автономно) |
| Платные настольные пакеты (Acrobat Pro) | Низкий или умеренный (Синхронизация с облаком) | Тяжелые (Дорогая подписка и большой объем диска) | Высокое (Исходные потоки сохраняются) | Умеренный (Телеметрия и фоновые бэкапы) |
Для системных администраторов консольные пакеты вроде pdfimages остаются надежной классикой. Однако современные браузерные веб-инструменты предоставляют точно такую же строгую изоляцию и побитовое качество, оставаясь мгновенно доступными любому сотруднику без работы в командной строке.
Пошаговое руководство: как извлечь графику высшего качества за 4 шага
Для быстрого извлечения иллюстраций с сохранением исходной четкости и полной конфиденциальности выполните следующие простые действия:
Перейдите в экстрактор PDF в изображения в любом современном веб-браузере. Вы можете отключить интернет или просмотреть вкладку Сеть в инструментах разработчика: утилита работает автономно и строго офлайн.
Перетащите файл в область загрузки. Браузер загрузит данные в локальную память устройства через HTML5 File API и FileReader.readAsArrayBuffer(). Если документ защищен паролем, появится локальное окно для ввода ключа, который расшифрует потоки по алгоритму AES без передачи ключа по сети.
Определите задачу. Если требуется получить встроенные фотографии и рисунки в их первозданном разрешении, нажмите Извлечь встроенные изображения. Если в файле присутствуют многослойные векторные схемы и сложная верстка, выберите Рендеринг страниц в 300 DPI для получения кристально четких листов целиком.
На экране появится интерактивная галерея обнаруженных изображений с их реальными размерами в пикселях и цветовыми профилями. Вы можете сохранить нужные картинки по отдельности или нажать Скачать все в ZIP для пакетной выгрузки без пережатия.
Сложные технические случаи: Пароли, цветовые профили CMYK и альфа-маски
В реальной инженерной и издательской практике файлы PDF часто имеют нестандартные внутренние параметры, из-за которых примитивные скрипты зависают или генерируют испорченные изображения. Глубокое понимание этих нюансов гарантирует безупречный результат в любых ситуациях:
1. Цветовая инверсия и конвертация из пространства CMYK
Буклеты, каталоги и упаковка, подготовленные к офсетной печати, традиционно верстаются в 4-канальной субтрактивной модели CMYK (Cyan, Magenta, Yellow, Key/Black). Если простой экстрактор воспринимает эти данные как RGB, на выходе получаются перевернутые, неестественно кислотные или блеклые цвета. Наш браузерный движок считывает словарь /ColorSpace и в реальном времени производит аппаратную ICC-трансформацию в памяти устройства, точно переводя координаты CMYK в стандартное пространство sRGB для дисплеев без потери полутонов.
2. Прозрачные силуэты и маски отсечения (/SMask)
В отличие от автономных файлов PNG, где прозрачность объединена с цветовыми каналами в единый массив RGBA, спецификация PDF разделяет цвет и маску обрезки. Полноцветное изображение хранится в обычном потоке RGB, а контур вырезания — в отдельном 8-битном полутоновом потоке /SMask. Базовые конвертеры отдают только цветной слой с жестким черным или белым фоном. Наш инструмент программно объединяет эти слои через виртуальный холст OffscreenCanvas, воссоздавая подлинный прозрачный PNG с безупречными контурами.
3. Строчные микроизображения, тайловые паттерны и пиктограммы
Мелкие значки, декоративные маркеры и текстурные фоны нередко прописываются прямо внутри потока текстовых инструкций страницы через операторы BI (Begin Image), ID (Image Data) и EI (End Image), минуя глобальный словарь /XObject. Выделение таких ресурсов требует глубокого синтаксического разбора потока токенов, который осуществляется высокопроизводительными библиотеками WebAssembly с максимальной точностью.
Корпоративные стандарты безопасности, аудит данных и экосистема
Службы информационной безопасности в банках, страховых компаниях и медицинских учреждениях постоянно контролируют исходящий трафик с помощью систем защиты от утечек (DLP). При передаче рабочих документов на неавторизованные облачные сервисы конвертации срабатывают протоколы инцидентов. Внедрение браузерных решений с полностью локальной обработкой исключает исходящий сетевой трафик, гарантируя безукоризненное соблюдение политик комплаенса и высокую производительность труда сотрудников.
Консалтинговая практика цифрового агентства afolksdigital.com помогает предприятиям корпоративного сегмента внедрять безопасные веб-инструменты и контуры локальной обработки документации. Отказ от дорогостоящих зарубежных SaaS-подписок позволяет бизнесу существенно сократить постоянные затраты на IT-инфраструктуру и навсегда исключить риск несанкционированного перехвата служебных файлов третьими лицами.
Для финансовых аналитиков, портфельных управляющих и специалистов казначейства, рассчитывающих финансовые коэффициенты, коэффициенты Шарпа и валютные курсы по корпоративным отчетам эмитентов, финансовые калькуляторы на academy.afolksdigital.com предлагают математически выверенные алгоритмы для профессиональных инвестиционных расчетов.
Если вы хотите обучить штатных IT-специалистов разработке безопасных клиентских сред на WebAssembly, синтаксическому анализу бинарных документов и проектированию архитектуры zero-trust, ознакомьтесь с комплексными обучающими программами на образовательном портале learn.afolksdigital.com.